
礦場營運
礦場故障怎麼提早發現:礦池告警與礦機指標的最小設定
一台機器半夜停了,應該十分鐘內知道,而不是隔天早上才發現。這篇整理 10–100 台規模礦場真正需要的最小監控配置:礦池端的免費告警、礦機本身的指標位址,以及值得設定的四條告警。
小型礦場最貴的故障,是沒有人發現的故障。一台機器半夜停機,你早上十點才看到,就少了十個小時的產出。所以 10–100 台規模的礦場不需要昂貴平台,真正能減少損失的最小配置只有兩層:礦池端的告警,以及礦機端的指標。
第一層:礦池端監控,免費而且該最先做
先把礦池帳號裡的監控打開。這一層不需要安裝任何東西,而且在礦機完全斷網時仍然有效——因為測量是礦池做的,不是礦機。
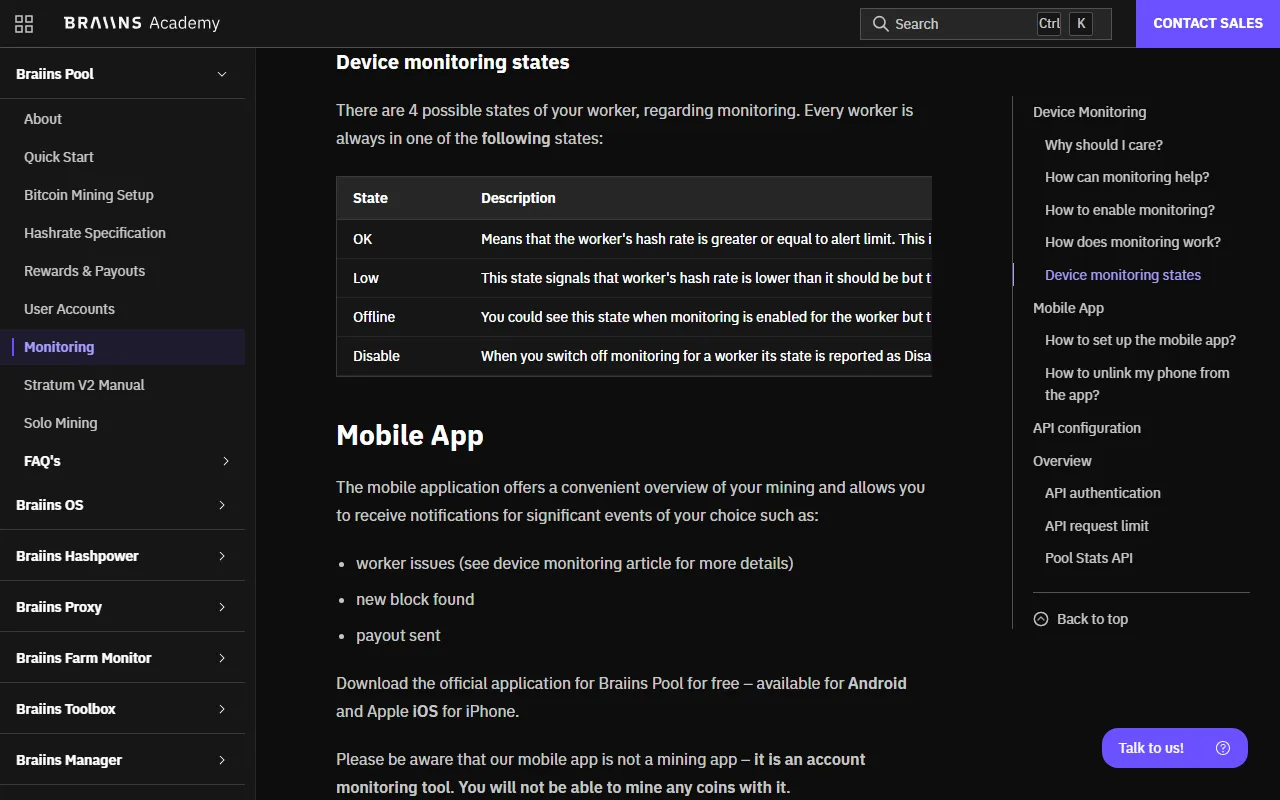
依 Braiins Pool 官方文件,監控在 Mining → Settings → Reporting 開啟(電子郵件或手機 App 通知),接著在每個 worker 的設定裡個別啟用。礦池每 5 分鐘對所有 worker 的有效算力做一次快照,再和 Alert limit 比較。門檻可以手動填,也可以讓系統依該 worker 過去的表現自動計算。
worker 永遠處於四種狀態之一,這個區分在實務上很重要:
- OK — 算力大於或等於告警門檻。
- Low — 機器還在提交 share,但算力低於應有水準。通常是散熱、自動降頻,或某一塊哈希板失效。
- Offline — 完全偵測不到算力。供電、網路,或機器整個停了。
- Disable — 該 worker 的監控是關掉的,也就是它出事不會有人知道。
一個實際建議:把 worker 名稱對應到機器的實體位置(例如排號加位號)。否則通知來了,你不知道要去找哪一台。
不要把 Low 和 Offline 當成同一件事。Offline 是要立刻到現場看的;Low 多半和溫度有關,可以先遠端排查,排查順序寫在算力下降的檢查順序這篇裡。
第二層:礦機本身的指標位址
礦池只看得到結果,也就是算力。原因(溫度、風扇轉速、功耗、拒絕率)要從礦機本身讀。
跑 Braiins OS 的機器會在各自的 [礦機IP]:8081/metrics 位址上輸出指標;原廠韌體的機器則由一個叫 metrics exporter 的服務代為收集。格式本來就是給 Prometheus 用的,所以你也可以直接用瀏覽器打開當純文字看。
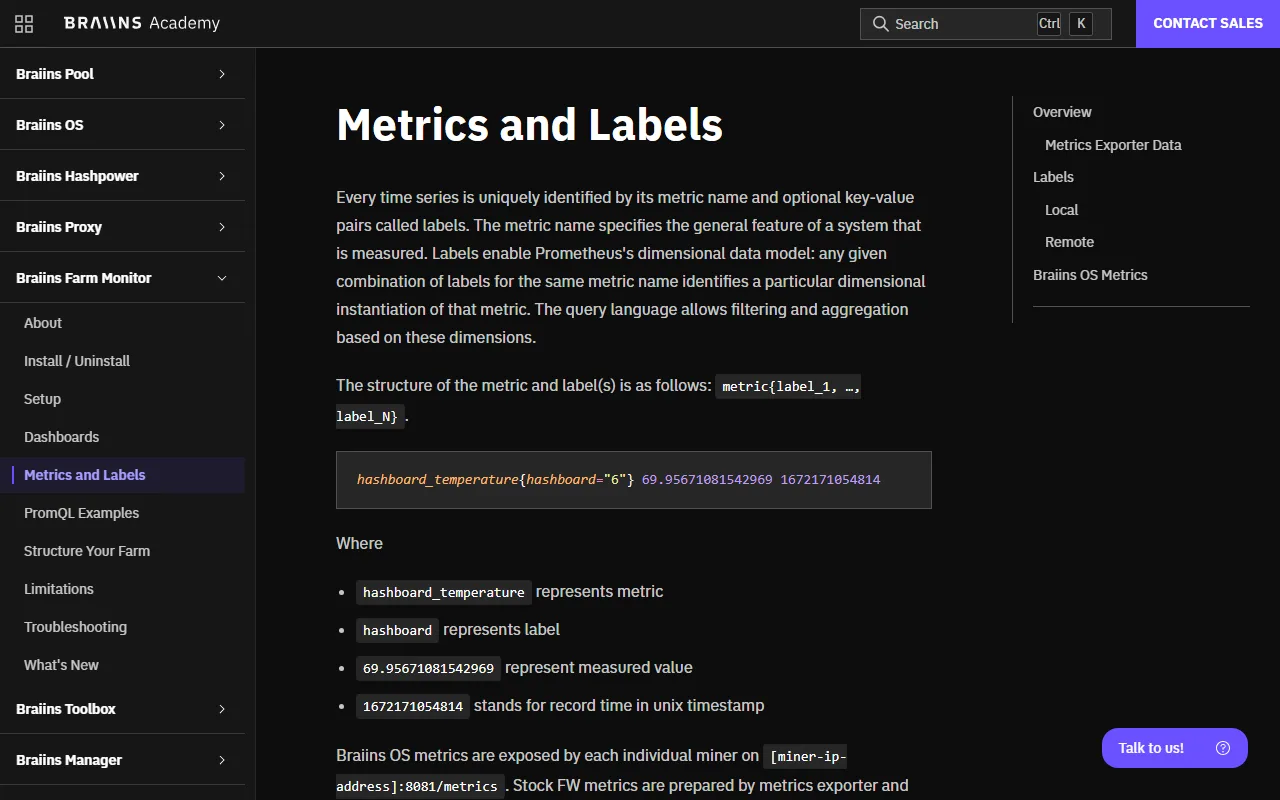
文件列出的指標裡,小型礦場真正用得到的是這幾項:
temperature— 晶片溫度(依哈希板與位置標記)。fan_rpm_feedback— 每顆風扇的實際轉速。average_hashrate_last_30_min_ghs— 30 分鐘平均算力,比瞬時值可靠得多。hashboard_nominal_hashrate_ghs— 標稱值,用來做比較基準。stratum_rejected_submits_counter— 被拒絕的 share 數。miner_power與miner_power_target_w— 實際功耗與目標功耗。up— 裝置是否有回應。
收齊這七項,「為什麼掉算力」這個問題大部分就能回答。
真正該設的四條告警
十來台機器不需要設幾十條告警——告警一多就變成雜訊,人就不看了。最小而有用的組合是:
- worker Offline — 在礦池端設,延遲 10–15 分鐘再通知。要留延遲,因為短暫斷網自己會恢復。
- 整場算力低於標稱 10% 以上、持續 30 分鐘 — 看的是整場而不是單機。這通常代表某塊哈希板死了,或好幾台同時在降頻。
- 晶片溫度逼近韌體裡的 Hot 門檻 — 具體數字依型號和韌體而不同,所以要從自己機器的介面讀出來,不要用猜的。
- 風扇轉速歸零或劇烈變化 — 這類訊號通常比溫度告警更早出現,能留給你處理的時間。
排第五、但仍值得加的是拒絕率上升:它多半指向網路或設定問題,而且直接影響收益。
需要 Prometheus 和 Grafana 嗎?
既然指標本來就是 Prometheus 格式,Prometheus + Grafana 是很自然的下一步。Braiins Academy 的範例裡,例如用 avg(max by (instance) (temperature)) 取所有機器最高溫的平均,用 sum(miner_power_target_w{type="current"}) 取總功耗。
但要誠實評估。十台機器,礦池告警加上每週看一次介面就夠了;一百台沒有圖表會很難做,因為你看的是趨勢和分組,不是單機。界線不該用台數來畫,而是問一個問題:一台機器停一整天沒人發現,你損失多少?如果這個數字超過架設和維護監控所花的時間成本,就該建。停機一小時的實際價格怎麼算,寫在停機與維修成本的計算方法這篇。
門檻怎麼定
最常見的錯誤是門檻定得太緊。算力本來就會波動,夏天溫度也會合理地上升,所以:
- 門檻綁在平均值上(30 分鐘或 24 小時),不要綁瞬時值。
- 每條告警都加一個持續時間:條件連續成立幾次才發通知。
- 每個季節重看一次門檻——夏天和冬天的「正常溫度」並不一樣。散熱成本的季節變化算在夏季散熱成本如何改變收益這篇裡。
- 事先決定哪些通知值得半夜吵醒你:Offline 和溫度算,拒絕率小幅上升不算。
一天之內可以做完的最小清單
- 在礦池帳號開啟郵件或 App 通知。
- 為每個 worker 啟用監控並設好門檻。
- 把 worker 名稱對應到實體位置。
- 打開任一台機器的
:8081/metrics頁面,確認數字真的有出來。 - 把上面四條告警寫下來,先用手動方式驗一遍。
- 故意關掉一台機器,量一下通知到底會不會來、要多久才來。
最後一步別跳過:沒驗證過的告警系統,等於沒有告警系統。
資料來源與說明
礦池端的監控邏輯、5 分鐘快照與 worker 狀態取自 Braiins Pool 官方文件的 Monitoring 頁;指標名稱、8081/metrics 位址與 PromQL 範例取自 Braiins Farm Monitor 文件的 Metrics and Labels 與 PromQL Examples 頁(2026-10-05 查核)。其他礦池與韌體的名稱、門檻與可用欄位可能不同,請以自己系統介面上的實際數值為準。文中建議的告警門檻是通用起點,實際數字要依場地溫度、機型與韌體版本調整。